
Не думал я, что в ближайшем будущем за это возьмусь, но решил из любопытства попробовать современные ИИ-модели — не научились ли они распознавать двуязычную речь, да еще и с диким акцентом, да еще и в таком отвратительном качестве записи. И я засунул в Google AI Studio запись 10-го урока. Вот как есть — без шумоподавления и прочих плясок, которые я обычно совершаю вокруг записи при ее реставрации — просто скачал с сайта и преложил к запросу. Большой удачей было то, что есть дословные транскрипты семи предыдущих уроков — я все их приложил в промпт, это позволило модели ознакомиться с манерой речи участников разговора и их вокабуляру и обещало заметно улучшить результат.
То, что я получил, привело меня в неописуемый восторг! Я даже пост сюда тут же выложил под названием «Это бомба!» Потому что модель показала не просто весьма приличное качество распознавания, а к тому же еще и грамотно обернутое всю эту прямую речь в великолепную пунктуацию. Да это же готовый Player+! Посудите сами!
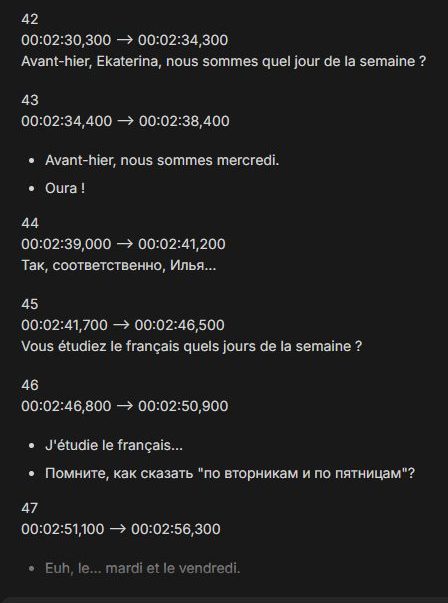
Радость моя оказалась преждевременной. Присмотритесь к таймкодам! Это круглые цифры. Она расставила временны́е метки от балды. Вырвала поражение из зубов победы*. © Как позже выяснилось, там еще и огромные куски остались нераспознанными. Я с грустью удалил свой пост. Это совсем не бомба.
Но глаза загорелись. Воодушевленный первым успехом, я решил, что ну да, на арапа не прокатило, нужно подойти к вопросу грамотно — и всё получится.
Я не буду тут расписывать все перипетии, которые пришлось пройти на этом пути. Точнее, я опишу это ниже для зануд и уберу под спойлер все детали реализации. По факту же получилось, что я просто заменил одну кропотливую и страшно занудную работу на другую. Семь дней — я проверил по датам создания файлов — не разгибаясь, с перерывами только на сон и еду я готовил этот Player+ с его 1600 реплик. Voilà — Player+ 10-го урока
Как все это было сделано технически — очень много букв и картинок
После первой неудачи я попробовал подойти со знанием дела. Была версия, что у модели не получается сосредоточить внимание и на распознавании речи, и на привязке реплик к временно́й шкале. Да и размер вывода в токенах не позволял качественно работать с записью такого размера.
Для начала я отреставрировал запись. Шумоподавление, удаление щелчков, стуков, кашля и длиннот, компрессия, эквализация… Я начал нарезать запись на куски с постоянным битрейтом и скармливать их разным моделям порциями. Не получалось ни-че-го. Точнее, я получил, пусть и не полный, набор распознанных реплик, но это было «пиво отдельно, мухи отдельно».
Тогда я попробовал поставить задачу по-другому: привязать готовые распознанные реплики к аудиодорожке. Звук есть, тексты большинства реплик есть — нужно их теперь просто сопоставит и синхронизировать. Эта техника называется forced alignment, и это уже более легкая задача, ведь теперь не нужно тратить ресурсы на распознавание. Такой подход сулил успех.
Еще раз: все такие задачи решаются современными ИИ-моделями на раз. Главная загвоздка моего кейса в том, что а) практически все полтора часа звука представляют собой разговор на смеси языков, один из которых произносится с чудовищным акцентом и ошибками и b) сама запись жутчайшего качества.
Работа переехала в облако Google Colab с графическим ускорителем Nvidia T4 с 16 ГБ видеопамяти. Google Colab — это такая среда, где ты на время решения своей задачи арендуешь облачную вычислительную мощность. Фактически, ты получаешь виртуальную Линукс-машину с деревом каталогов в одном окне (куда ты загружаешь свои рабочие файлы), терминалом в другом и ячейками, в которых можно запускать команды операционной системы, скрипты на Python или просто писать заметки. Такие сеансы Гугл оформляет как своеобразный блокнот, в котором сохраняются все, что было вычислено или загружено в оперативную память (например, тяжелые веста нейросети) — эдакий аналог файла hibernation в Windows. После окончания сеанса такой блокнот сохраняется на Google Drive, и его всегда потом можно открыть и продолжить работу с той точки, в которой ты остановился прошлый раз.
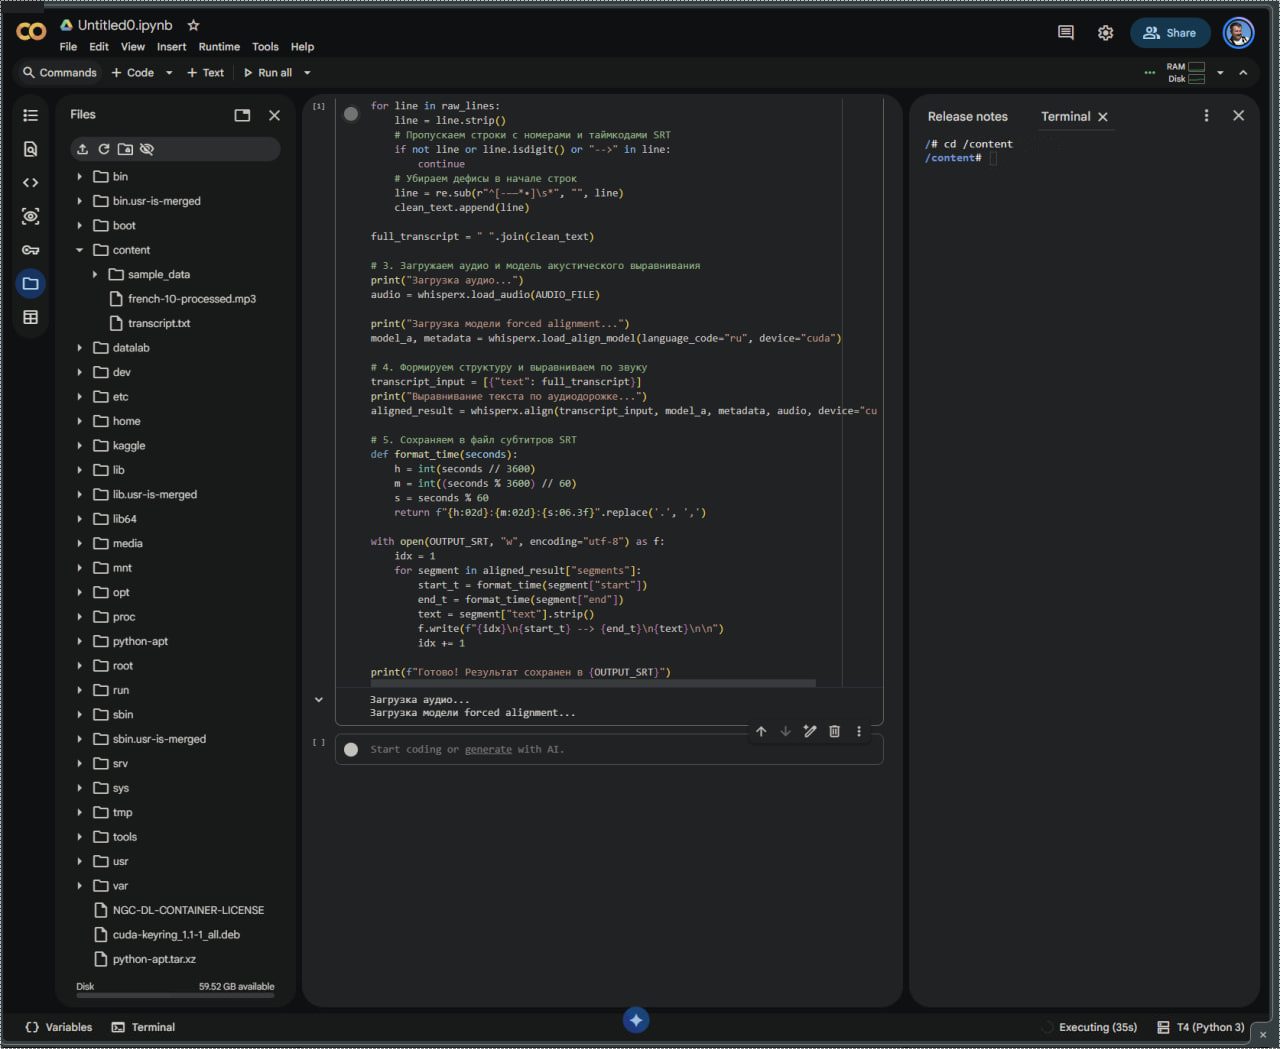
Я подписался на Hugging Face (те самые, кого недавно хакнули сбежавшие ИИ-агенты) и установил на виртуальную машину в Colab’е их модель pyannote/speaker-diarization-3.1 — на ней скрипт и проводил диаризацию — так по-научному называется этот процесс привязки реплик аудиодорожке (и дикторам тоже, и даже в первую очередь к дикторам).
На выходе я получил довольно сырой файл субтитров без разбиения на голоса, то есть без обозначения, кто какую реплику произнес. Я загрузил полученный результат в Subtitle Editor — и оказалось, что привязка эта тоже очень условная, плюс-минус лапоть, и куча нераспознанных кусков.
Я собрал два распознанных разными моделями набора реплик и попробовал объединить их в один сет с заменой плохо распознанных на хорошо распознанные. В итоге обнаружилось, что довольно большая часть диалога просто сочинена ИИ на основе транскриптов предыдущих уроков. Она сочиняла ответы на вопросы, расширяла реплики, пыталась шутить…
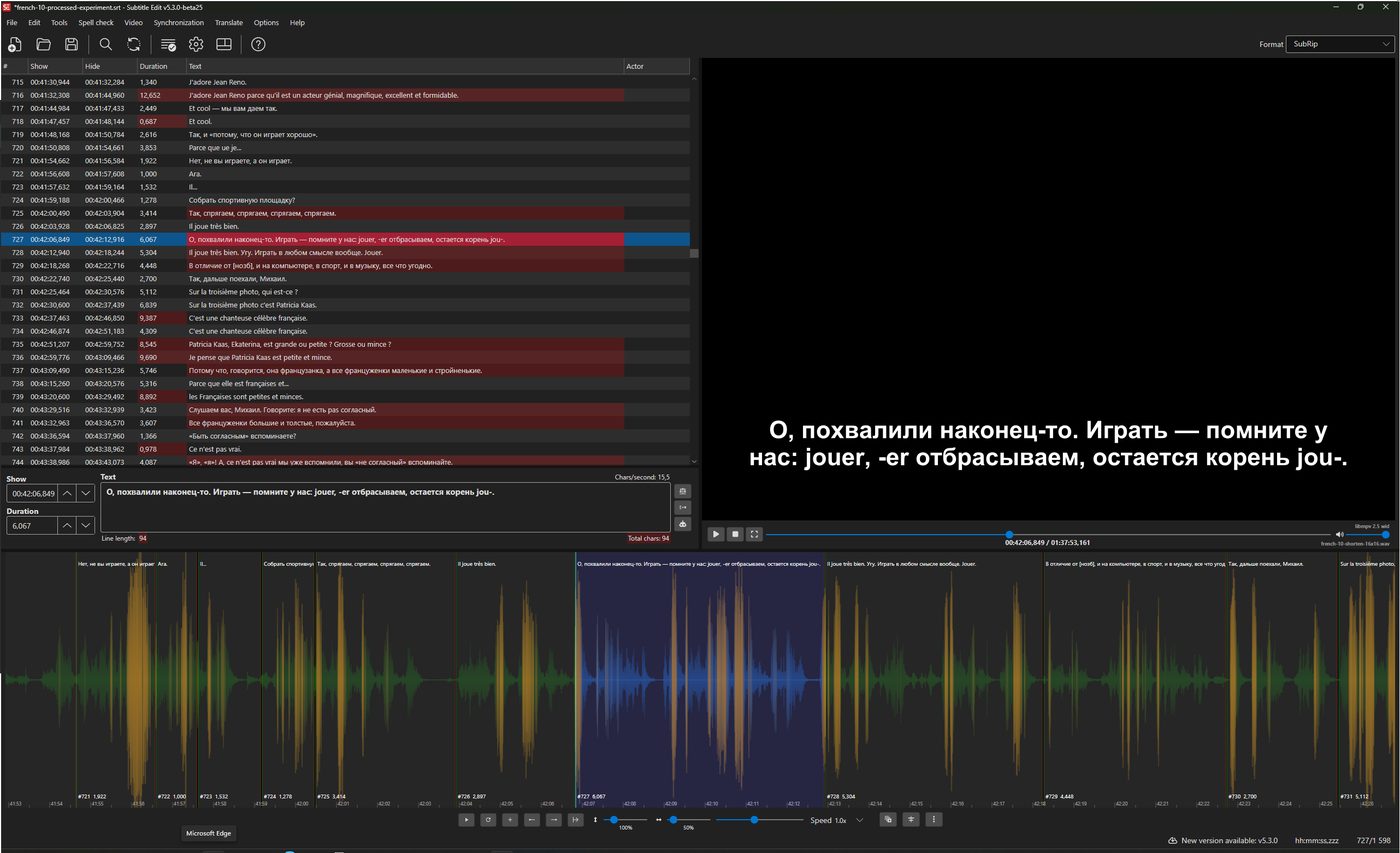
Я попробовал внутри Subtitle Editor’а (SE) запустить распознавание пропущенных кусков локально на скачанной и запущенной на ПК модели Whisper для распознавания мультиязычной речи — SE это позволяет. Он это делает, но хуже, чем облачные модели Google.
В итоге я получил более или менее правдоподобный набор реплик более или менее повязанных к таймлайну. И начал двигать их мышкой, расставляя в нужные позиции и корректируя длительность реплик. Это была самой частью всей работы и заняло половину времени — я провозился с этим дня три, обрабатывая примерно по полчаса записи в сутки.
Полученные субтитры я снова запустил в Google Colab — уже для настоящей диаризации — чтобы приписать каждой реплике ее автора.
Полученный на предыдущем этапе набор субтитров, которые уже были привязаны к их авторам, я перенес уже в привычный академически инструмент ELAN
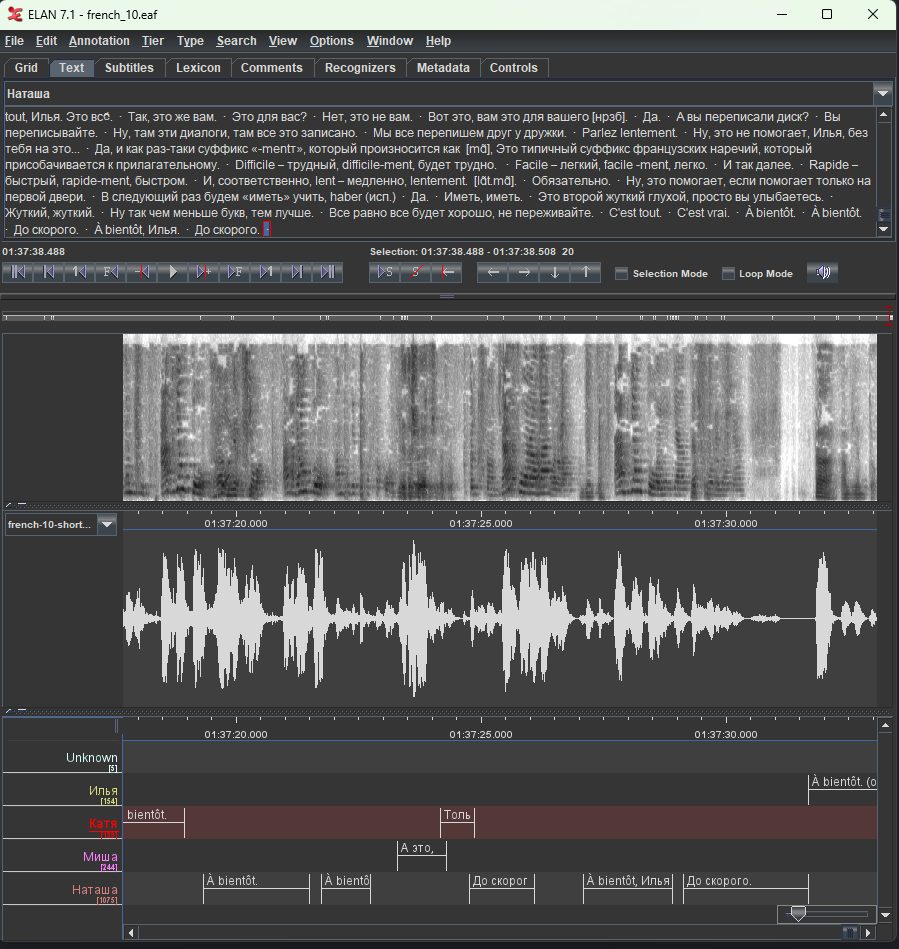
Здесь я снова прошелся внимательно по всей записи. Что значит прошелся? Прослушал ее, корректируя разблюдовку реплик. Ошибок было процентов 20%, поэтому не расслабишься. Попутно корректировал ошибки распознавания.
Когда все было завершено, я сконвертировал итоговый файл в DOCX и загрузил его в MS Word. Тут уже идет шлифовка.
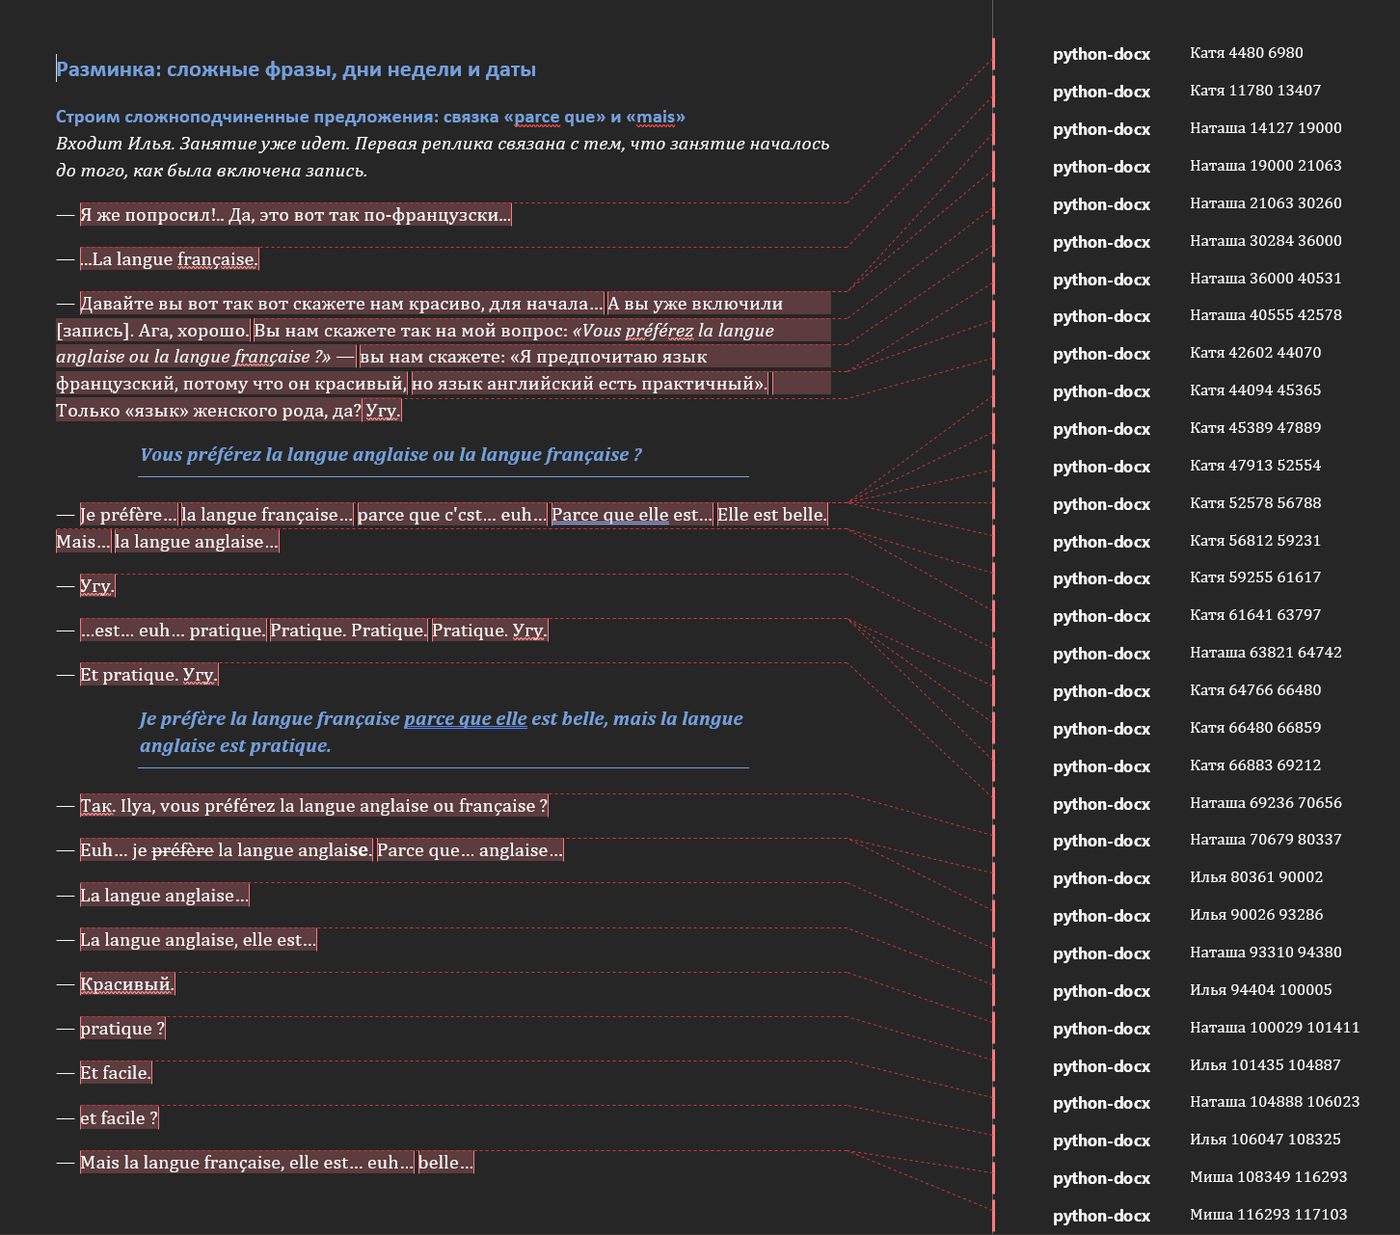
Ты в очередной раз вынужден вычитывать эти тексты, параллельно слушая саму запись. Я приспособил педаль от телесуфлера для пуска / паузы аудиодорожки в работающем в фоне плеере и для отмотки воспроизведения на 5 секунд назад, чтобы не переключаться между окнами. Последний рабочий день ушел на эту вычитку, верстку и вставку заголовков и материалов из учебника.
*Вырвал поражение из клыков победы — объяснение, откуда эта фраза (просто много букв)
Эта фраза принадлежит Брюсу Тоньяццини (Bruce Tognazzini) по прозвищу Тог, автору колонки о дизайне интерфейсов в журнале для разработчиков Apple. Далее идет цитата из замечательной статьи Джоэла Сполски Руководство по UI дизайну для программистов (User Interface Design For Programmers). Джоэл Сполски, в прошлом сотрудник Microsoft — один из основателей Stack Overflow.
---------------<cut here>
Тог придумал концепцию «панель меню высотой в километр» для того, чтобы объяснить преимущество панели меню Macintosh перед той же панелью в Windows. В Windows панель появляется внутри каждого нового окна приложения. Чтобы открыть пункт меню (например, File), нужно прицелиться и поймать мышью прямоугольничек размером полтора сантиметра на сантиметр. От пользователя требуется аккуратное и точное позиционирование стрелки мыши как по вертикали, так и по горизонтали.
В Macintosh же панель приклеена вверху видимой области экрана. Это дает вам возможность швырять мышь как угодно высоко по вертикали — курсор всегда окажется вверху экрана, то есть точно на высоте панели меню. Как следствие, прицел ваш точно также ограничен полутора сантиметрами в ширину, но уже километром в высоту. Все, что вам нужно сделать, это лишь правильно расположить курсор по горизонтали; о позиционировании курсора по вертикали уже позаботился Macintosh, и открыть пункт меню стало вдвое проще.
Этот же принцип лежит и в основе проводимой Тогом мини-викторины: какие пять областей экрана легче всего найти с помощью мыши? Ответ: четыре угла экрана (вы можете в буквальном смысле швырнуть мышь, совершенно не заботясь о позиционировании стрелки) и текущая позиция курсора.
Принцип панели высотой в километр достаточно известен, но, похоже, не совсем очевиден, поскольку команда разработчиков Windows 95 ухитрилась его совершенно неверно интерпретировать. Кнопку «Пуск» они расположили в самом нижнем левом углу экрана, но — почти в самом нижнем левом углу экрана. Отступ снизу составляет два пикселя, отступ слева — тоже два пикселя. Из-за какой-то несчастной пары пикселей Microsoft «вырвал поражение из клыков победы», как образно выразился Тог, и вынудил пользователей терять больше времени на то, чтобы кликнуть по кнопке «Пуск». Кнопка могла бы быть квадратным километром, абсолютно тривиально достижимым мышью. Но ради чего-то — мне не известного — этим пренебрегли.
Нам нужна ваша помощь. Пожалуйста, поддержите Le-francais.ru !
